 Cloud Ops Chronicles
L'ingénierie DevOps à l'ère des agents autonomes : principes et convictions
- Introduction
- Partie 1 : Règles de gouvernance et intégration aux processus DevOps
- Partie 2 : Architecture système, scalabilité et outillage
- 5. Le dialogue, l’orchestration et l’exécution sont découplés
- 6. L’orchestration est asynchrone, durable et consciente de la concurrence
- 7. MCP standardise les intégrations ; les contrôles indépendants en bornent l’autorité
- 8. Privilégier les outils déterministes plutôt que de laisser le modèle deviner (Deterministic-First)
- Partie 3 : Sécurité, identité et protection des données
- Partie 4 : Opérations, fiabilité et FinOps
- Du manifeste à un premier pilote
- Conclusion
- Références et portée des sources
Introduction
Les équipes DevOps assurent au quotidien la disponibilité, l’évolution et la sécurité d’environnements applicatifs de plus en plus complexes. Une alerte à investiguer, une dépendance à mettre à jour ou un changement d’infrastructure mobilisent souvent les mêmes activités : rechercher du contexte, analyser des symptômes, modifier du code, lancer des vérifications et préparer une décision.
J’ai la conviction aujourd’hui que l’avenir de ce métier passe par l’ingénierie de plateformes agentiques permettant de prendre en charge une partie de ce travail avec des agents logiciels capables d’utiliser des outils et de poursuivre une mission dans la durée. Aussi, j’ai la conviction que l’objectif n’est pas de remplacer l’ingénieur, mais de lui donner un appui opérationnel, tout en conservant les processus de revue et de livraison de l’équipe.
Par exemple, à la suite d’une demande ou d’une alerte de supervision, un agent pourrait consulter les informations de monitoring, investiguer un problème et préparer une modification dans GitLab. Il rendrait compte de ses observations, demanderait des précisions si nécessaire et soumettrait ses changements à la revue. Les approbations requises et la livraison vers les environnements applicatifs resteraient gouvernées par les processus existants.
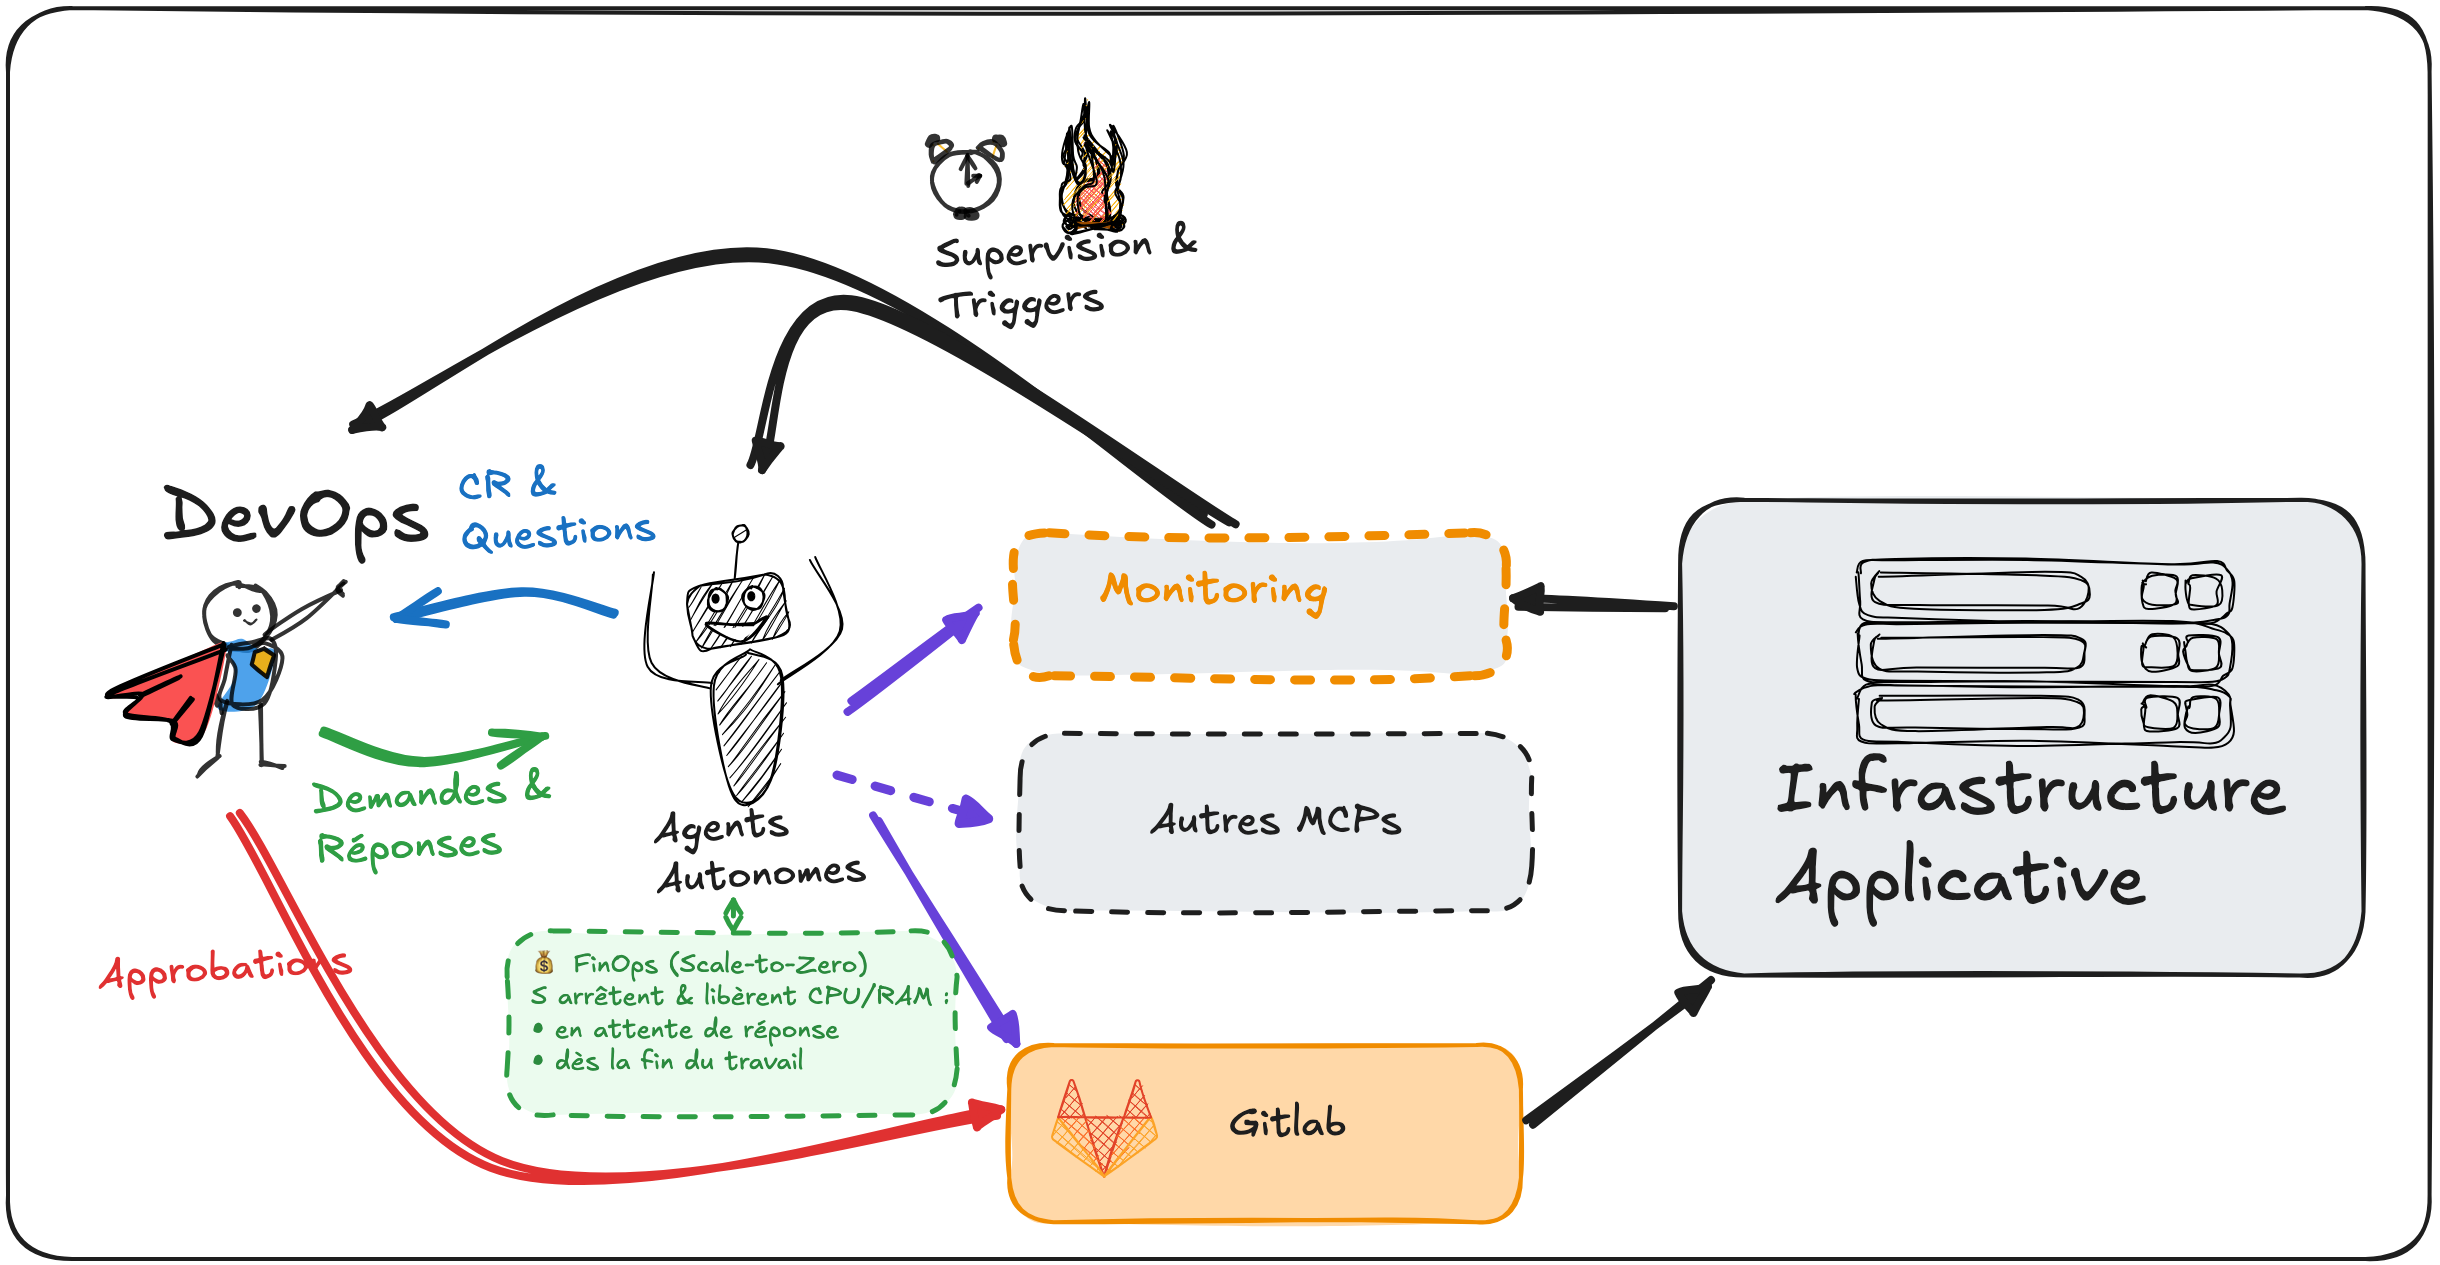
Vue de principe : les agents assistent l’équipe et utilisent les outils à leur disposition ; l’humain conserve les décisions et approbations qui lui reviennent.
Aujourd’hui, l’usage de l’intelligence artificielle dans les opérations IT en entreprise se traduit essentiellement par deux approches :
- L’assistant dépendant du poste de travail : les assistants intégrés aux IDE accompagnent utilement les développeurs, mais leur présence sur le poste et la validation successive de commandes ne constituent pas, à elles seules, une plateforme d’exécution industrialisée.
- L’agent autonome sans cadre de confiance : des agents autonomes commencent à être expérimentés, mais leur confier des accès de production sans isolation ni contrôles indépendants expose l’organisation aux erreurs, aux injections de prompt et à l’abus de privilèges.
Aucune de ces deux solutions n’étant satisfaisante, l’avenir passera par des agents autonomes encadrés, disposant de leurs propres ressources d’exécution, plutôt que par une délégation illimitée d’autorité à un modèle. Ces agents doivent s’intégrer aux processus d’ingénierie comme des membres de l’équipe technique, tout en étant soumis à des exigences renforcées de traçabilité, d’isolation et de validation.
Même si l’IDE peut rester une interface de pilotage, l’exécution de fond et ses droits ne doivent pas dépendre des ressources ou des identifiants du poste du développeur.
Pour concrétiser cette vision, ma plateforme cible s’appuie sur un Cloud (GCP), un orchestrateur d’agent (Google AX), une sandbox (Agent Substrate), et des outils (OpenCode, MCP, etc.). Ce harness désigne l’environnement logiciel qui transforme le modèle (IA Générative) en agent : boucle d’exécution, outils, gestion du contexte et interactions avec la sandbox. Le modèle n’est qu’un composant de ce système.
Ce manifeste décrit un ensemble d’exigences que je m’impose, et en aucun cas une certification de l’implémentation actuelle. Les mécanismes cités doivent être qualifiés et validés avant d’être utilisés.
Partie 1 : Règles de gouvernance et intégration aux processus DevOps
1. L’humain conserve l’autorité décisionnelle
Ma conviction : l’autonomie doit s’exercer dans un cadre explicite. L’agent peut investiguer, proposer et réaliser des opérations autorisées ; il ne peut ni s’accorder de nouveaux droits, ni s’attribuer une approbation humaine.
La méthode :
- L’ingénieur passe du rôle d’artisan du code ou de l’infrastructure à celui de superviseur : il formule une mission, fixe les contraintes et arbitre les décisions structurantes.
- La plateforme authentifie le demandeur, humain ou système, et vérifie son droit de lancer une mission sur le projet et la cible concernés. Les déclencheurs automatiques, notamment les webhooks de supervision, sont authentifiés, autorisés et protégés contre le rejeu ; leur origine est conservée dans la trace de la mission.
- Certaines opérations courantes peuvent être préautorisées par une politique ou un runbook. Mais les actions mutatives critiques nécessitent une approbation explicite, proportionnée au risque.
- Lorsque le contexte reste ambigu, l’agent sollicite une décision humaine via un outil dédié (par exemple de type
ask_human). La plateforme organise sa mise en pause et sa reprise. - La séparation des tâches (Segregation of Duties, SoD) est imposée by-design hors de l’agent : auteur, approbateur et identité de déploiement sont distincts. L’agent ne peut approuver sa propre contribution, modifier les règles d’approbation ou contourner le pipeline.
- Une approbation est liée à un objet précis : dépôt, MR, SHA, environnement et opération. Une modification pertinente du contenu impose une nouvelle validation.
- Si une fonction GitLab nécessaire dépend d’une édition ou d’une offre non disponible, un contrôle indépendant équivalent doit être établi et testé ; le prompt n’est pas un substitut.
Références : R02, R13, R14, R16.
2. Le code revu et la chaîne de livraison gouvernée sont le chemin vers la production
Ma conviction : un agent ne doit pas modifier directement un cluster ou une ressource Cloud de production au détour d’une commande. Les changements applicatifs et d’infrastructure suivent le même processus gouverné que ceux des ingénieurs.
Cette règle ne confond pas les changements de production avec le provisionnement de sandboxes ou les mises à jour d’état métier, réalisés par le plan de contrôle dans un périmètre préautorisé.
La méthode :
- Les agents travaillent sur des branches dédiées, ouvrent des Issues et soumettent des Merge Requests. Ils suivent les pipelines et corrigent les échecs sans affaiblir les contrôles.
- La chaîne de livraison valide, construit et promeut les artefacts de staging vers la production, selon les autorisations et approbations requises.
- Les contrôles de sécurité et de release ne sont pas modifiables unilatéralement par l’agent dont ils évaluent le travail.
- L’origine et l’intégrité des commits et artefacts sont attestées par des signatures et des preuves de provenance, liées au SHA testé et au digest déployé. Si une signature GPG dédiée à l’agent est retenue, sa clé privée reste dans un service de signature de confiance, hors sandbox.
- Une signature atteste une origine et une intégrité ; elle ne prouve ni la qualité du code ni son approbation humaine.
- L’historique s’appuie sur des références Git protégées, des preuves CI et un journal d’audit protégé. Git seul ne rend pas toute l’administration du dépôt inviolable.
- Le rollback est préparé et testé : un
git revertchange l’intention versionnée, mais n’annule pas instantanément une migration de données ou une suppression d’infrastructure.
Que la livraison passe par un pipeline CI/CD (terraform apply) ou par un contrôleur de réconciliation continue (GitOps), Git reste l’unique point d’entrée vers la production.
3. La supervision humaine doit résister à la fatigue d’approbation
Ma conviction : multiplier les demandes d’approbation vagues conduit au rubber-stamping. La qualité du dossier de décision importe davantage que le nombre de clics.
La méthode :
- Les demandes d’approbation sont regroupées dans des Merge Requests. Lorsqu’un agent a besoin de privilèges supplémentaires (par exemple l’autorisation d’accéder à une nouvelle URL d’egress), cette demande est soumise sous forme de Merge Request et versionnée dans un dépôt GitOps dédié, garantissant une auditabilité complète.
- Chaque Merge Request ou demande d’approbation présente un dossier synthétique : problème, hypothèse de cause racine, changements proposés, preuves de tests, impact, incertitudes et plan de retour arrière.
- Une hypothèse générée par le modèle est distinguée d’un fait vérifié par un outil.
- Les demandes expirées ou devenues obsolètes sont signalées. Une réponse ne doit pas relancer une autre tâche ou valider un nouveau SHA à l’insu du relecteur.
- La plateforme mesure la charge de supervision : demandes par tâche, délais de réponse et échecs après approbation.
4. Le contexte est du code versionné, pas une autorisation
Ma conviction : la connaissance locale doit vivre au plus près du code. Elle ne doit pas être confondue avec la politique de sécurité de la plateforme.
La méthode :
- Les fichiers
AGENTS.md,opencode.json, les instructions de build et les conventions du dépôt évoluent par revue, comme les autres fichiers d’ingénierie. - Les règles transverses, skills et politiques sont centralisés et versionnés. La plateforme enregistre les versions effectivement utilisées pour chaque exécution.
- Les instructions de confiance sont séparées des données externes : Issues, logs CI, documents, pages web, descriptions d’outils et résultats MCP sont identifiés comme des contenus potentiellement non fiables.
- Les entrées sont sélectionnées, bornées et analysées avant d’alimenter le contexte. Un contenu tronqué est indiqué comme incomplet et reste récupérable par un chemin contrôlé.
- Des filtres, dont Model Armor lorsque son intégration est qualifiée, complètent cette séparation. Ils réduisent le risque d’injection ; ils ne garantissent pas son élimination.
- Les droits, budgets et règles d’approbation sont appliqués par des composants de confiance, même si le modèle ignore ses instructions ou si le dépôt contient des instructions malveillantes.
- Le contexte d’apprentissage est un actif d’ingénierie à part entière. Un agent est aussi bon que le contexte qu’on lui donne : les skills (comment faire) et la mémoire (ce que l’équipe sait déjà) se travaillent, se testent et s’améliorent comme du code. Un agent sans mémoire repart de zéro à chaque mission et refait les mêmes erreurs.
- La mémoire partagée prend la forme d’un wiki Markdown versionné en Git (décisions d’architecture, post-mortems, conventions, pièges connus), lisible aussi bien par les ingénieurs que par les agents. Ce que l’équipe apprend profite ainsi à tous.
- L’agent peut proposer des écritures dans cette mémoire (leçon apprise, correction d’une page obsolète), mais uniquement via une merge request relue par un humain. Une connaissance non relue ne devient jamais une instruction : cela évite qu’une erreur ou un contenu empoisonné ne se propage de mission en mission.
- Chaque page de mémoire a un responsable et une date de dernière revue ; une connaissance périmée est corrigée ou retirée. Le wiki reste du contexte, jamais une autorisation.
Partie 2 : Architecture système, scalabilité et outillage
5. Le dialogue, l’orchestration et l’exécution sont découplés
Ma conviction : l’interface conversationnelle ne doit pas être bloquée par une compilation, une investigation longue ou une attente humaine. Ce découplage n’impose pas de multiplier les agents ou les modèles sans nécessité.
La méthode :
- Un tchat de type Copilot porte le dialogue, la compréhension de la demande et le pilotage ; des agents d’exécution disposent d’une sandbox, d’un système de fichiers et des outils de développement nécessaires.
- Le journal durable, les contrôles d’autorité et les mécanismes de reprise ne reposent pas sur la survie du seul processus qui exécute le code.
- La capacité d’exécution est allouée à la demande, selon les limites d’admission et les besoins réels de la tâche.
- Le routage multi-modèles est gouverné : un modèle rapide et économique peut traiter les demandes simples ; un modèle plus capable intervient lorsque les évaluations démontrent son intérêt.
- Le routeur prend en compte qualité, coût, latence, confidentialité, capacités des outils et contraintes géographiques. Une escalade de modèle ne doit pas augmenter les droits de l’agent.
- Lorsqu’un parseur, un compilateur ou une règle déterministe suffit, il n’y a pas lieu d’appeler un modèle pour lire une structure ou reformater du JSON.
6. L’orchestration est asynchrone, durable et consciente de la concurrence
Ma conviction : une mission d’ingénierie dépasse le cycle de vie d’une requête réseau. Son état et ses décisions doivent survivre aux redémarrages, aux réponses tardives et aux livraisons répétées d’événements.
La méthode :
- Un middleware de messages, tel que Pub/Sub, sépare les ordres et les événements avec deux topics logiques (commandes et événements). Il ne s’agit pas de deux middlewares indépendants.
- Une base d’état telle que Firestore constitue le pivot métier pour les conversations, missions, exécutions, questions, droits et corrélations. GitLab reste l’autorité sur ses Issues, MR et pipelines ; l’orchestrateur d’agents reste l’autorité sur ses ressources d’exécution.
- Chaque événement et chaque tentative possèdent un identifiant unique. Les changements d’état d’une tâche (
en cours,en pause,terminée) sont dédupliqués et protégés contre les messages arrivés en retard ou dans le désordre. - Les appels externes (API GitLab, publication d’événements) nécessitent un mécanisme de reprise explicite, une transaction en base de données ne pouvant pas couvrir un appel réseau externe. Les opérations répétées, comme la création d’une Issue, utilisent des identifiants de corrélation et des contrôles de déduplication ou de réconciliation adaptés au service cible.
- L’UI reçoit des projections persistées et resynchronisables, par exemple via SSE. Une coupure du navigateur ne doit pas perdre une question ou transformer une attente en succès.
- La concurrence est contrôlée selon la cible : plusieurs agents peuvent analyser ou travailler en parallèle sur des branches isolées et réaliser les opérations GitLab autorisées. Les réponses humaines et les reprises sont liées à la bonne mission et à son état courant ; les mutations incompatibles sur un même objet sont coordonnées pour éviter les conflits.
- La production passe par Git et la CI/CD : les agents ne modifient pas directement les ressources de production et ne manipulent pas les verrous d’infrastructure de livraison. La chaîne CI/CD réalise ces opérations et utilise notamment le verrouillage de l’état Terraform lorsque le backend le permet.
Pour faire dialoguer l’agent de pilotage (tchat de type Copilot) et les agents d’exécution en tâche de fond, cette orchestration s’inspire du protocole A2A (Agent-to-Agent) et de son cycle de vie de tâche (working, input-required, completed, failed). Si un bus Pub/Sub suffit à transporter ces événements en interne, l’ouverture à des agents tiers conformes au standard A2A implique d’implémenter ses contrats protocolaires explicites (HTTP, SSE et notifications asynchrones).
Références : R01, R06, R19, R20, R26.
7. MCP standardise les intégrations ; les contrôles indépendants en bornent l’autorité
Ma conviction : les intégrations doivent être modulaires et explicites. Un protocole commun facilite leur évolution, sans constituer à lui seul une frontière de sécurité.
La méthode :
- Les intégrations de la sandbox privilégient des serveurs MCP spécialisés, en transport local
stdio, notamment pour GitLab et les échanges humains. - Les outils sont décrits par des schémas, découverts et invoqués selon la version MCP retenue. Une interface compatible permet de faire évoluer le harness sans réécrire toute l’intégration métier.
- Les fichiers, compilateurs, tests et commandes Git peuvent rester des outils locaux du harness. Le shell ou une CLI ne doivent jamais contourner les autorisations imposées aux accès externes.
- La supply chain des outils est qualifiée : sources approuvées, versions figées, digests ou empreintes vérifiés, dépendances inventoriées et mises à jour soumises à évaluation.
- Les signatures, par exemple avec Cosign, et les attestations de provenance s’appuient sur une chaîne de confiance explicitement définie. Les identités et clés de signature de confiance restent hors du runtime non fiable.
- Binary Authorization peut imposer une politique d’admission aux images sur GKE. Il ne valide pas automatiquement chaque serveur MCP téléchargé après démarrage ; ces extensions nécessitent leurs propres contrôles.
- Une signature valide ne signifie pas qu’un outil est exempt de défauts ou de comportement malveillant. Les descriptions et résultats des outils restent soumis à la séparation des données non fiables.
Références : R07, R15, R17, R18, R27.
8. Privilégier les outils déterministes plutôt que de laisser le modèle deviner (Deterministic-First)
Ma conviction : un modèle de langage (LLM) est probabiliste : il excelle pour comprendre un problème et rédiger du code ou une configuration, mais il ne faut jamais lui demander de deviner ou de simuler ce qu’un outil déterministe (compilateur, linter, test) peut vérifier avec exactitude.
La méthode :
- L’agent utilise le modèle pour analyser le besoin et proposer un changement, puis exécute obligatoirement les outils déterministes dans sa sandbox (linters, compilateurs,
terraform validate,helm template, tests unitaires et scanners de sécurité) avant de pousser son code ou de solliciter une revue humaine. - La preuve de bon fonctionnement repose sur la sortie réelle des outils (commandes lancées, codes de retour et artefacts de test) attachée au code testé, et jamais sur une simple affirmation du modèle indiquant que le code est valide.
- Tout contrôle requis non exécuté ou en échec reste visible et bloque la suite du processus : l’agent doit corriger son code ou escalader le blocage, sans contourner le test.
- Un test qui passe valide les cas qu’il couvre dans son environnement d’exécution, tout en gardant un coût de calcul mesurable et reproductible.
Partie 3 : Sécurité, identité et protection des données
9. Le runtime est non fiable ; secrets et autorisations restent sous contrôle extérieur
Ma conviction : un agent qui lit des sources externes et exécute du code doit être considéré comme potentiellement compromis. L’isolation zero-secret réduit l’exposition des identifiants ; elle ne supprime pas l’autorité des opérations autorisées.
La méthode :
- Isolation : chaque tâche utilise une sandbox isolée des autres workloads. gVisor apporte un noyau applicatif en espace utilisateur ; ce n’est pas, par définition, un hyperviseur de micro-VM. Le mode d’exécution, les montages et les frontières réelles sont documentés.
- Identité propre (Non-Human Identity) : chaque tâche possède une identité machine logique distincte ; chaque exécution porte une capacité attestée, liée au demandeur, au dépôt, à la cible et à la politique autorisée. Un équipement déterministe de type proxy/firewall déduit cette identité d’un contexte contrôlé par la plateforme qu’il authorisera ou non.
- Moindre privilège : les droits accordés à un agent sont limités dans le temps et restreints aux seuls projets, branches et opérations nécessaires à sa mission.
- Identifiants externalisés : les PAT GitLab, jetons OAuth d’intégration et clés de signature de confiance ne sont pas confiés à la sandbox et à l’agent. L’agent utilise des placeholders ou des capacités locales bornées ; les vrais identifiants sont détenus par un composant de confiance (proxy/firewall).
- Durée de vie et révocation : la plateforme privilégie des jetons éphémères lorsque le fournisseur le permet (comme les jetons OAuth Cloud). Lorsque le service cible utilise des jetons à plus longue durée de vie (comme un PAT GitLab), c’est le proxy de sortie qui borne l’autorisation à la durée de la tâche et permet de la révoquer immédiatement.
- Egress gouverné : le proxy extérieur autorise les destinations et les opérations, puis injecte l’identifiant approprié. Une allowlist de domaines ne suffit pas : un domaine autorisé peut héberger une autre cible ou recevoir des données qui ne devaient pas lui être transmises.
- Entrées et sorties : les données externes et résultats d’outils sont analysés, minimisés et bornés. Model Armor et les règles d’analyse complètent les limites d’autorité ; ils ne remplacent ni l’isolation ni l’autorisation.
- Confidentialité : secrets applicatifs, données personnelles et contenus confidentiels font l’objet d’une politique de classification et de masquage avant transmission au modèle ou persistance. Ne pas remettre de credentials à l’agent ne garantit pas que les fichiers qu’il lit n’en contiennent jamais.
- Résidence et souveraineté des données : au-delà de la gouvernance de la plateforme d’exécution (cluster, sandboxes, micro-VMs), il est essentiel de définir une gouvernance explicite de la localisation des données et de la fourniture du service d’inférence. La localisation du stockage (bases, snapshots, journaux) et celle de l’inférence LLM sont vérifiées séparément : héberger l’infrastructure en Europe ne suffit pas si le modèle est appelé via un endpoint
global. La plateforme impose donc des endpoints régionaux conformes aux exigences de résidence retenues, sans repli automatique vers une région ou un fournisseur non autorisé. Un endpoint régional ne suffit cependant pas à établir la souveraineté : les engagements du fournisseur, le traitement des métadonnées, les accès du support et le recours éventuel à des sous-traitants doivent aussi être examinés au regard des exigences applicables.
Références : R01, R03, R08, R09, R13, R21, R22, R23.
Partie 4 : Opérations, fiabilité et FinOps
10. L’exécution est jetable ; l’état utile et la capacité de reprise sont durables
Ma conviction : la survie d’une mission ne doit pas dépendre de spécificité historique d’un serveur (parametrage manuel, précédente mission, …). Aussi une attente humaine ne justifie pas de conserver un processus de travail actif indéfiniment.
La méthode :
- Chaque nouvelle exécution reçoit un environnement contrôlé, neuf ou restauré explicitement. Les résidus d’un autre agent ne sont pas réutilisés implicitement.
- A la fin des exécution, les fichiers utiles, références Git, questions et états de workflow sont archivés (stockés de manière peu coûteuse) avant libération de la capacité d’exécution.
- Un snapshot de disque permet une reprise à froid ; il ne promet pas une restauration de la RAM ou des processus. La reprise vérifie l’identité de l’exécution, les autorisations et la validité de la réponse.
- La libération de capacité dispose d’un SLO mesuré. Un snapshot en échec ou un processus qui ne s’arrête pas est signalé, pas masqué par un statut de succès.
- La suspension libère la capacité active de l’agent ; les workers, nœuds, bases, réseau et stockages partagés peuvent continuer à coûter.
- Les TTL et tâches de nettoyage, éventuellement déclenchés par webhook (via par exemple un cron Cloud Scheduler), respectent la propriété des ressources et les politiques de rétention des preuves.
- La continuité d’activité couvre les sauvegardes, restaurations, indisponibilités du modèle et reconstructions de l’environnement. Les objectifs de reprise et de perte de données acceptable sont définis et testés.
Arrêt d’urgence global (Kill Switch) : un opérateur autorisé doit pouvoir arrêter l’admission de nouvelles missions, mettre en quarantaine les déclencheurs fautifs, bloquer les nouvelles actions sensibles au proxy et proceder l’arrêt des exécutions. Ce contrôle et son canal d’audit ne dépendent pas de la coopération du LLM.
Les files, DLQ, journaux et snapshots sont conservés par défaut pour investiguer et reprendre. Une purge est exceptionnelle, autorisée et documentée. Les opérations déjà engagées sont réconciliées avant une reprise contrôlée et idempotente ; l’arrêt n’annule pas magiquement un effet externe déjà réalisé. Le délai d’application de l’arrêt est mesuré, et le repli manuel des équipes est documenté.
Références : R01, R09, R10, R14, R15, R26.
11. Des garde-fous budgétaires et anti-boucles stricts (FinOps Cognitif)
Ma conviction : un agent autonome confronté à une erreur complexe peut entrer dans une boucle infinie d’essais/erreurs et consommer des millions de tokens en quelques minutes sans résultat. Les limites doivent être bloquantes et appliquées par la plateforme, pas seulement par des alertes de facturation.
La méthode :
- Quotas par mission (Circuit Breakers) : chaque tâche est soumise à un nombre maximal d’itérations, une durée maximale d’exécution et un budget maximal de tokens/appels LLM, incluant ses éventuelles reprises et sous-tâches.
- Double contrôle (interne et hors sandbox) : la boucle de l’agent (le harness) vérifie ces seuils à chaque étape, mais c’est le proxy hors de la sandbox qui bloque physiquement les nouveaux appels vers l’API du modèle si le quota est atteint.
- Plafonds bloquants plutôt que simples alertes : une alerte budgétaire Cloud signale un dépassement après coup sans couper les appels ; la plateforme impose donc ses propres compteurs par tâche et par période. Les appels parallèles sont pris en compte à l’admission, par exemple par une réservation de budget, puis rapprochés de leur consommation effective.
- Arrêt et escalade : lorsqu’une tâche atteint sa limite sans converger, la plateforme bloque les nouveaux appels, demande l’arrêt de l’exécution et remonte le diagnostic des échecs à l’ingénieur, sans nouvel appel au LLM. Les appels déjà engagés peuvent toutefois se terminer et générer des coûts supplémentaires ; leur consommation est comptabilisée et le dépassement éventuel est signalé.
- Suivi du coût complet et optimisation : le suivi FinOps comptabilise l’ensemble des coûts (tokens consommés y compris lors des essais en échec, exécution des sandboxes et infrastructures partagées) rapportés à chaque tâche validée. L’usage de modèles plus légers, du cache de prompt et de la réduction du contexte permet d’optimiser ce coût sans dégrader la qualité ni la confidentialité.
12. L’audit porte sur les décisions, actions et preuves observables
Ma conviction : comprendre un incident exige une trajectoire d’exécution exploitable. Cela ne signifie pas disposer d’une copie exhaustive et fidèle de la pensée interne du modèle.
La méthode :
- Les traces corrèlent demandeur, tâche, exécution, identité, versions du modèle, du contexte et des outils, appels, résultats, erreurs, approbations, SHA, artefacts et consommation annoncée.
- Le journal durable est protégé contre les modifications par l’agent et permet de reconstruire les événements observés.
- Les hypothèses et justifications explicites du modèle sont distinguées des preuves issues des outils. Les résumés de raisonnement disponibles peuvent aider au diagnostic, sans être considérés comme une preuve exhaustive du calcul interne.
- La plateforme n’exige pas la capture d’une chaîne de pensée privée comme condition d’auditabilité.
- Les données sont minimisées et filtrées avant journalisation et avant envoi à l’API d’inférence. Sensitive Data Protection, anciennement Cloud DLP, peut contribuer au masquage.
- Masquage, pseudonymisation et anonymisation ne sont pas interchangeables. Un détecteur ne garantit pas d’identifier tous les secrets ; les accès, le chiffrement, les lieux de traitement et la rétention restent indispensables.
- Les traces détaillées ne sont pas publiques par défaut. Leur accès et les éventuelles exceptions de collecte sont gouvernés et audités.
- Les conventions OpenTelemetry GenAI peuvent faciliter l’interopérabilité des signaux ; leur version et leur couverture doivent être précisées.
Références : R11, R12, R14, R22, R25.
13. Les agents sont évalués comme des systèmes complets
Ma conviction : changer un modèle, un prompt, un outil ou un contrôle peut dégrader silencieusement la fiabilité. La qualification concerne le système entier, pas seulement la réponse du modèle.
La méthode :
- Un banc d’essai comporte des dépôts de référence, bugs connus, pipelines en échec, mises à jour de dépendances et scénarios de supervision.
- Plusieurs essais sont exécutés par scénario pour mesurer la variabilité. Réussite, régressions, coût, latence, actions interdites et interventions humaines sont suivis.
- Les évaluations de capacité sont distinguées des tests de non-régression. Les seuils de promotion sont définis et les résultats liés aux versions effectivement évaluées.
- La réussite est vérifiée dans l’environnement : le bon changement, sur la bonne cible, avec les preuves et approbations attendues. Une réponse « terminé » n’est pas une preuve.
- Les cas adversariaux couvrent notamment injections indirectes, exfiltration, auto-approbation, images ou outils non autorisés, événements dupliqués, reprise après pause, dépassement de budget et arrêt global.
- Les erreurs de persistance, indisponibilités et restaurations font partie de la qualification. Les tests simulés sont distingués des preuves d’intégration et de déploiement réel.
- Une mise à jour échouant aux critères requis n’est pas promue. Une suite réussie mesure les risques et comportements couverts ; elle ne certifie pas une sécurité absolue.
Références : R12, R13, R14, R15.
Du manifeste à un premier pilote
Pour passer de la théorie à la pratique, la démarche doit être progressive et pragmatique :
- Un périmètre de départ restreint : démarrer avec une équipe pilote sur quelques dépôts, uniquement sur des cas d’usage simples et à faible risque (par exemple analyser un échec de pipeline CI ou préparer une Merge Request de mise à jour de dépendance). Les règles existantes s’appliquent : l’humain valide et la CI/CD déploie.
- Des indicateurs de succès simples :
- Efficacité : la tâche est-elle résolue sans reprise manuelle ?
- Gain de temps : l’ingénieur gagne-t-il du temps sans subir une surcharge d’approbations ?
- Coût : quel est le coût réel complet (tokens et ressources Cloud) par tâche réussie ?
- Sécurité : respect strict des limites (zéro contournement, zéro action interdite).
- Une montée en charge maîtrisée : le périmètre ne s’élargit à de nouveaux projets ou à des tâches plus complexes qu’après validation de ces résultats avec l’équipe.
Conclusion
L’industrialisation de l’IA pour le DevOps ne consiste pas à trouver un modèle magique auquel confier les clés du royaume. Elle consiste à construire le système qui encadre son autonomie.
Je veux une plateforme dans laquelle les agents peuvent produire, tester et investiguer efficacement, mais ne peuvent ni augmenter leurs droits, ni approuver leur propre travail, ni cacher leurs échecs. L’autorité, les preuves et la durabilité doivent rester indépendantes du runtime potentiellement compromis.
L’isolation, les identifiants externalisés, les politiques d’accès, la livraison gouvernée, les budgets, la reprise et les évaluations rendent cette ambition vérifiable. La préparation à la production est une qualification à démontrer, pas une propriété acquise par l’assemblage de technologies.
Références et portée des sources
Sources primaires consultées le 8 novembre 2026. Les spécifications de protocole, référentiels de risque, documentations produits et retours d’expérience n’ont pas la même portée. Ils appuient ces principes sans certifier cette plateforme ni imposer une unique architecture. Les versions applicables et engagements fournisseur doivent être vérifiés lors de l’implémentation.
| Réf. | Source | Apport principal et limite |
|---|---|---|
| R01 | Anthropic — How we built Claude Managed Agents | Séparation harness, sandbox et session durable ; externalisation des identifiants. Retour d’expérience, pas obligation de reproduire le service. |
| R02 | Anthropic — Building effective agents | Workflows, routage, agents et critères d’arrêt ; privilégier la simplicité et justifier la complexité. |
| R03 | Anthropic — Claude Code sandboxing | Fatigue d’approbation, isolation et proxy d’authentification contrôlé ; ne valide pas notre configuration. |
| R04 | AGENTS.md — projet officiel | Format ouvert pour le contexte et les instructions locales ; pas une politique d’autorisation. |
| R05 | OpenGitOps — principes | Déclaratif, versionné et immuable, récupération automatique et réconciliation continue. |
| R06 | A2A — spécification officielle | Modèle de données, opérations et transports pour l’interopérabilité ; un bus interne ne suffit pas à établir la conformité. |
| R07 | MCP — architecture | Contrat de contexte et d’outils, architecture client/serveur et transports ; ne dicte pas toute l’architecture de l’agent. |
| R08 | NIST SP 800-207 — Zero Trust Architecture | Autorisation centrée sur les ressources, sans confiance implicite liée au réseau ; pas une certification du proxy. |
| R09 | gVisor — introduction à l’architecture | Noyau applicatif, frontières d’isolation et limites, notamment à l’intérieur du workload. |
| R10 | FinOps Foundation — FinOps for AI Overview | Coût complet, attribution et coût par résultat réussi ; ne se limite pas aux tokens. |
| R11 | Anthropic — Reasoning models don’t always say what they think | Contre-exemples empiriques de fidélité des chaînes de pensée ; une trace n’est pas une preuve exhaustive du raisonnement. |
| R12 | Anthropic — Demystifying evals for AI agents | Évaluation du harness et du modèle, essais répétés, résultats réels, capacités et non-régression. |
| R13 | OWASP GenAI — Top 10 LLM et LLM01 Prompt Injection | Entrées indirectes, séparation des contenus, moindre privilège et tests adversariaux ; pas de prévention infaillible annoncée. |
| R14 | NIST — AI Risk Management Framework | Gouvernance et gestion du risque sur le cycle de vie ; référentiel volontaire, pas certification de production. |
| R15 | Google — Secure AI Framework (SAIF) | Fondations de sécurité, détection, réponse et contrôles cohérents ; cadre conceptuel. |
| R16 | GitLab — réglages d’approbation des MR | Exclusion de l’auteur ou des contributeurs, verrouillage des règles et retrait d’approbations ; fonctions selon l’offre. |
| R17 | SLSA — framework | Intégrité et assurance de la supply chain ; le niveau et les preuves doivent être précisés. |
| R18 | Google Cloud — Binary Authorization | Politiques d’admission et attestations d’images ; ne contrôle pas tous les téléchargements internes à une sandbox. |
| R19 | HashiCorp — Terraform state locking | Verrouillage des écritures d’état si le backend le supporte ; ne pas le remplacer par un simple verrou d’admission. |
| R20 | Google Cloud — transactions Firestore | Atomicité des écritures et rejeu des fonctions transactionnelles ; pas de transaction globale avec GitLab. |
| R21 | Google Cloud — Model Armor | Analyse des entrées/sorties et seuils de détection ; compromis entre faux positifs et faux négatifs. |
| R22 | Google Cloud — Sensitive Data Protection | Détection et transformations de désidentification ; couverture dépendante des détecteurs et de la configuration. |
| R23 | Google Cloud — résidence des données et traitement ML | Distinction stockage/traitement et engagements par modèle et endpoint ; un endpoint global ne garantit pas une résidence régionale. |
| R24 | Google Cloud — budgets | Distingue budgets avec alertes seules et plafonds disponibles pour certains services ; couverture à vérifier. |
| R25 | OpenTelemetry — conventions GenAI | Signaux de spans, métriques et événements, dont MCP ; version et couverture à qualifier. |
| R26 | Google Cloud — Pub/Sub exactly-once delivery | Garanties conditionnelles de livraison ; ne rend pas atomiques tous les effets d’un workflow. |
| R27 | MCP — bonnes pratiques de sécurité | Risques et protections spécifiques aux intégrations MCP ; complète les autres frontières de confiance. |